
Fragen Sie die Unit under Test. Erhalten Sie eine belastbare Antwort.
In Verifikation und Validierung liegen Testdaten, Stücklisten, Konfigurationen und Anforderungen in getrennten Systemen. explore verbindet sie zu einem Agentic Twin, der in natürlicher Sprache antwortet, aus geprüften Beziehungen statt aus Vermutungen.
Die Daten sind da. Die Antworten fehlen.
Testergebnisse, Stücklisten, Konfigurationen und Prozessdokumente leben in Systemen, die nicht miteinander sprechen. Eine einzige Frage, etwa ob ein Fehlerbild schon auf der vorherigen BOM-Revision auftrat, kostet Stunden manuellen Zusammensuchens.
Die Folge sind langsame Ursachenanalyse, wiederholte Tests, verzögerte Freigaben und Gewährleistungsrisiken. Und wer KI einfach auf einen Data Lake setzt, bekommt flüssige, aber nicht nachvollziehbare Antworten.
Manuelles Zusammensuchen
Jede Frage erfordert das Stitchen über Testmanagement, PLM, ALM und Sensordaten hinweg, jedes Mal aufs Neue.
Plausibel statt korrekt
RAG auf dem Data Lake findet ähnlich aussehenden Text, nicht die richtige Beziehung. Welche BOM-Revision zu welchem Testlauf gehört, kann es nicht verlässlich sagen.
Nicht auditierbar
Eine plausibel falsche Antwort ist in V&V schlimmer als keine: eine Aussage, die Sie im Audit oder Rückruf nicht verteidigen können.
Wiederholte Tests
Ohne verlässliche Historie werden Tests neu gefahren statt wiederverwendet. Das verzögert Freigaben und bindet Prüfkapazität.
Ein Agentic Twin für Verifikation und Validierung
explore vereint Testdaten, die Unit under Test, ihre Stückliste, Konfiguration und Anforderungen in einer semantischen, typsicheren Schicht, über alle Quellsysteme hinweg. Ingenieure fragen in natürlicher Sprache, der Agent antwortet aus geprüften Beziehungen.
„Warum ist es ausgefallen, auf welchem Build, und wo ist dieses Teil sonst noch verbaut?" ist in Sekunden beantwortet, nicht in Stunden. Jede Antwort ist als Pfad bis zum Quellsatz nachvollziehbar.
Der Twin antwortet nicht nur, er beobachtet Stückliste, Konfiguration und Testaufbau und meldet Risiken im Kontext, als Hinweis im Testaufbau oder im BOM-Editor, ohne dass jemand fragen muss.
Der Wert liegt in den Beziehungen, nicht in den Daten. Jede Quelle ist für sich nützlich. Über typisierte Beziehungen verbunden, beantworten sie Fragen, die keine von ihnen allein beantworten kann. Modellieren Sie die Verbindungen einmal, und jede künftige Frage erbt sie.
Was der Agentic Twin in V&V leistet
Beziehungen als native Traversierung
Welcher Lauf, welche BOM, welche Konfiguration: eine native Graph-Traversierung statt fragiler Mehrtabellen-Joins oder zufälliger Texttreffer.
Typsicherheit durch Ontologie
Das Schema erzwingt Typen. Der Agent kann nur verbinden, was erlaubt ist, und erfindet keine Beziehungen, die es nicht gibt.
Multi-Hop-Fragen
Vom Fehler über das Teil und den Lieferanten bis zu weiteren betroffenen Konfigurationen: eine einzige Abfrage statt einer Kette manueller Schritte.
Auditierbare Antworten
Jede Antwort führt auf die exakten Quellsätze zurück, bereit für Audit, regulatorische Prüfung und Gewährleistungsverteidigung.
Grounded by design
Frage rein, typsichere Graph-Abfrage raus, belastbare Antwort zurück. Der Agent operiert nur auf geprüfter Struktur, nicht auf Vermutungen.
Zwei Modi, ein Twin
Pull: Sie fragen, der Twin antwortet. Push: Der Twin prüft den Graphen fortlaufend und warnt im Kontext, bevor Sie fragen.
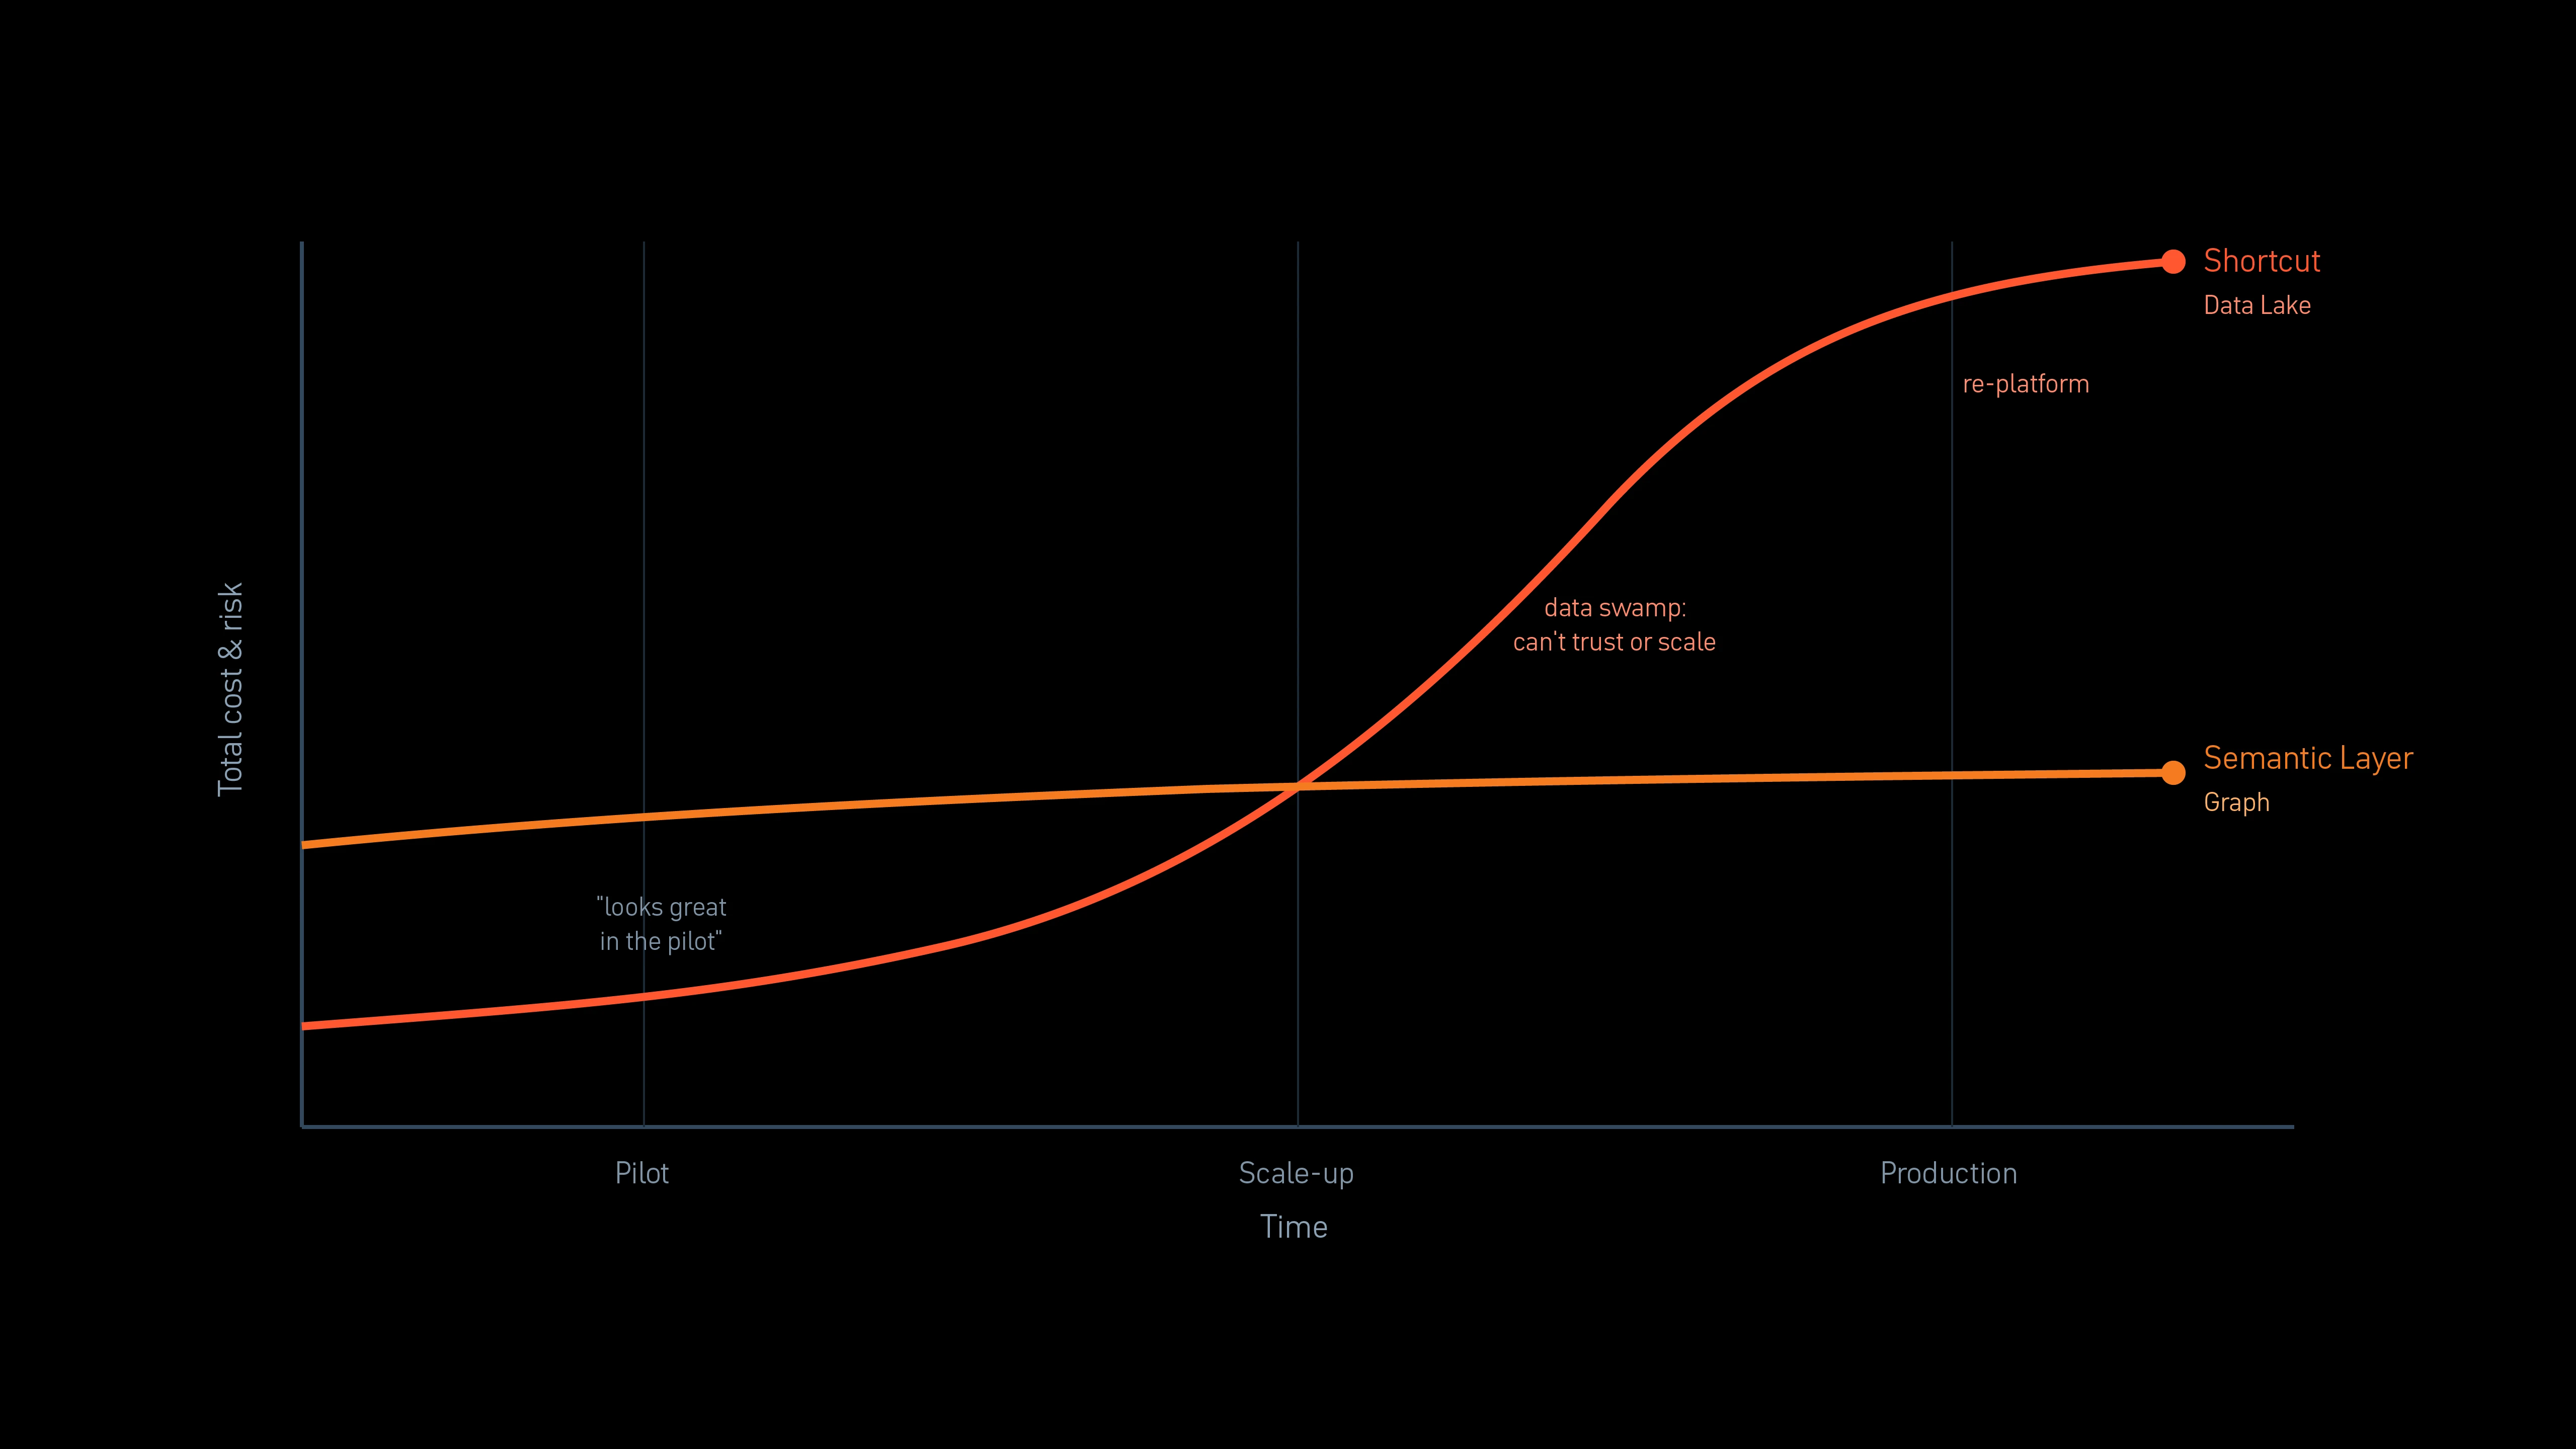
Der typsichere Graph ist die Grundlage, die mitskaliert
Eine semantische, typsichere Graph-Schicht ist die Grundlage, auf der alles aufbaut. Beziehungen sind belastbar, Typesafety ist sichergestellt, jede Antwort ist ein nachweisbarer Pfad. Wer diese Grundlage einmal richtig legt, hält Kosten und Risiko flach, während die Nutzung wächst.
Der Data Lake behält dabei seinen Platz: Die Testdaten selbst dürfen dort liegen bleiben, im Graphen werden sie nur referenziert, nicht dupliziert. Die Beziehungen und Typen leben im Graphen, die Rohdaten dort, wo sie schon sind.
Was die semantische Schicht zurückzahlt
Illustrative Zielwerte, projektspezifisch zu validieren.